Tesla K40c で llama.cpp を動かして、Local LLMを動かしてみた記録
はじめに
大学の研究室に、Tesla K40cというGPUが転がってました。
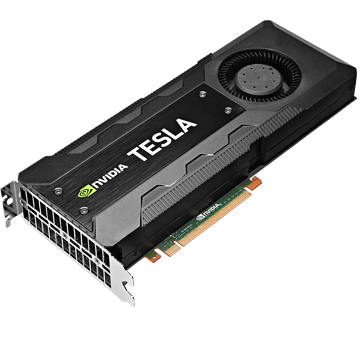
調べてみると、2013年発売で、Keplerアーキテクチャというものらしいです。
ビデオメモリは12GB GDDR5らしいのでこれはLocal LLMに使えるのでは?と思ったのですが…
思ったより色々面倒でした。
ATTENTION今回の作業は、2026/09/25 ~ 30 に行った作業です。 もしかしたら、今後使っているフォークが修正されるかもしれないので、そのあたり気をつけてください
Ubuntuで環境作るよ!
どうやらこのGPUは古すぎるようで、最新のUbuntuではうまく使えないようです。
なので、ちょっと古いUbuntu 20.04を使いました。
ProxmoxでUbuntuのVMを起動して、Tesla K40cをPCIeパススルーしました。
NVIDIA Driver 470.256.02を使って認識させて、CUDA Toolkit 11.4を入れました。
これでまず、CUDAプログラムの実行環境を構築できました。
llama.cppを入れたいよ!
Local LLMを使うためにはなにがいるんじゃろなと調べていたら、どうやらllama.cppというLLMをローカルで実行するための推論エンジンが必要なようです。
早速入れてみようとしたところ、どうやらKepler世代には対応していないようで…
どうにかならんかと色々探したところ、下のようなフォークを発見しました。
https://github.com/babal35/llamacpp-kepler
これで、llama.cppをKepler世代のGPUで動かせるようになるようです。
ほんまかいな。
早速使ってみよう!しかし…
先ほどのGithubから git clone して、以下の感じでビルドしてみました。
ここまでAIに頼りっぱなしです。
git clone https://github.com/babal35/llamacpp-kepler
cd llamacpp-kepler
mkdir -p build
cd build

cmake ..
  -DGGML_CUDA=ON
  -DCMAKE_CUDA_COMPILER=/usr/local/cuda-11.4/bin/nvcc
  -DCMAKE_CUDA_ARCHITECTURES=35
  -DGGML_CUDA_GRAPHS=OFF
  -DGGML_NATIVE=OFF
  -DCMAKE_BUILD_TYPE=Release
  -DLLAMA_BUILD_TESTS=OFF

make -j$(nproc)
早速使ってみようとすると、CUDAエラーで異常終了してしまいました。
-ngl というオプションでGPUへオフロードするレイヤー数を指定できるらしいのですが、
-ngl 1 → 正常に動作
-ngl 2以上 → CUDAエラー
みたいな動作になってしまいました。
動くには動くんですが、100%GPUの能力を使えていないのは悲しいですよね。
cuBLASエラー?ってのが原因か
AIさんに頼みまくって、デバック情報を出させながら何回もビルド&実行をしました。
そしたらついに原因を見つけてくれました。
CUBLAS_STATUS_INVALID_VALUE
AIさん曰く、
呼び出し経路を調査すると、CUDAバックエンドの行列積演算で使用されるcuBLASの
Math Mode設定が問題になっていた。 具体的には、cublasSetMathMode()に渡される設定として、次の定数が使用されていた。
CUBLAS_TF32_TENSOR_OP_MATHTF32はAmpere世代以降のNVIDIA GPUで導入された演算形式である。 しかし、Tesla K40cはKepler世代であり、TF32に対応していない。 このため、当時使用したllama.cppのCUDAバックエンドで、対応していない
Math Modeを設定しようとしてエラーになっていた。
らしいです。はえ~。
ソースコードを編集するよ!
以下のファイルに問題の設定があったみたいです。
ggml/src/ggml-cuda/common.cuh
このファイルで、CUBLAS_TF32_TENSOR_OP_MATH となっていたところを、CUBLAS_DEFAULT_MATH に変更しました。
コマンドでやるなら、こんな感じ。
cp ggml/src/ggml-cuda/common.cuh
   ggml/src/ggml-cuda/common.cuh.bak

sed -i
  's/CUBLAS_TF32_TENSOR_OP_MATH/CUBLAS_DEFAULT_MATH/g'
  ggml/src/ggml-cuda/common.cuh

cmake --build build -j$(nproc)
再ビルドすると、cuBLASエラーが解消されて、大規模オフロードが可能になりました!
Local LLMを使ってみるんじゃい
| モデル | gpt-oss-20b |
| パラメータ | 20.91B |
| 量子化 | MXFP4 |
| ファイルサイズ | 11.27 GiB |
こんな感じのモデルでベンチマークを測りました。
オプションは下みたいな感じで。
./build/bin/llama-bench
  -m /path/to/gpt-oss-20b-MXFP4.gguf
  -ngl 999
  -nkvo 0
  -fa 0
  -nopo 1
  -r 1
結果は…
| 速度 | |
|---|---|
| Prompt Processing(pp512) | 144.92 tokens/s |
| Token Generation(tg128) | 18.34 tokens/s |
まぁまぁ使えるんじゃないですか?
API 公開して研究室で使えるようにしたよ
./build/bin/llama-server
  -m /path/to/gpt-oss-20b-MXFP4.gguf
  -ngl 999
  -c 4096
  --host 127.0.0.1
  --port 8080
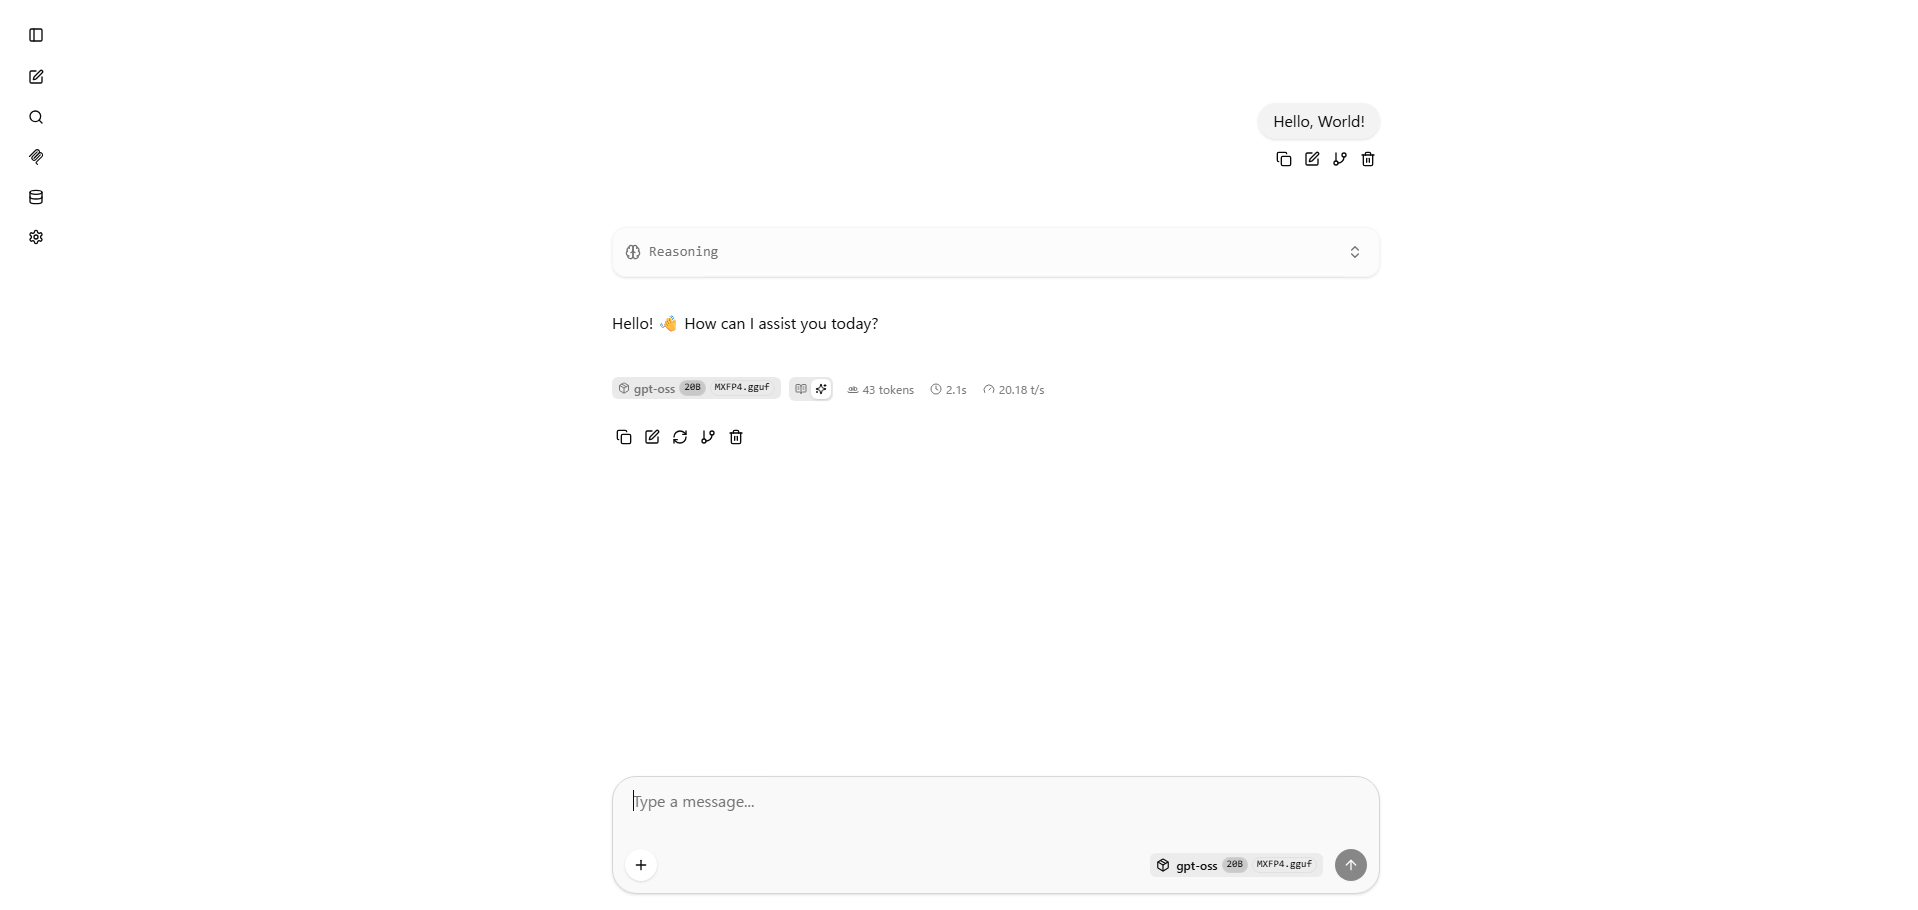
これでVMのIPアドレス、8080ポートにアクセスすれば、GUIで使うことができました!
まとめ
流石に電力効率が悪すぎて、最新のGPUには遠く及びませんが、機密情報とかプライベートな情報を投げて処理させるにはちょうどいい感じじゃないでしょうか。
Aliexpressを見たら17000円くらいだったので、お手軽LLMとしては悪くないかも?
(Tesla P100とかV100のほうがいいかもしれん⋯)
コメント 0
コメントを書く
コメントには会員ログインが必要です。 ログイン